买AI卡翻车的,多半不是买贵了,是买错了。贵这件事顶多肉疼一阵子,买错是要命的:卡塞不进机箱、驱动装不上、显存差一口气跑不动模型、二手卡还没保修,最后全砸手里。英伟达主流ai卡就那么几个系列,可每个系列对应的场景差得挺远,先想清楚自己要干什么,比先看价格重要得多。
英伟达主流ai卡大概分三类,别混着看
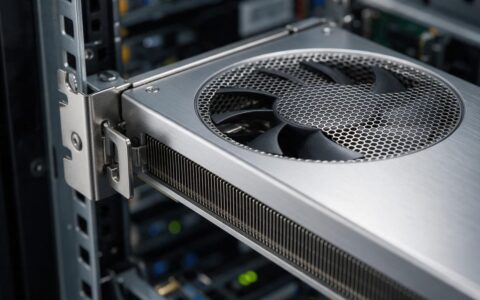
按用途粗分,一类是数据中心卡,A100、H100 这些,为长时间满载设计,被动散热、要靠服务器风道吹,显存带纠错,多卡之间还有专门的互联通道;一类是推理卡,L4、L40S 这类,功耗低、单槽或双槽,能塞进普通机箱,跑推理和轻量微调挺合适;还有一类是消费级游戏卡,RTX 4090 这种,价格亲民,拿来学模型、跑小规模推理完全够用,但没有纠错显存、卡间互联弱,多卡堆起来效率打折。至于每张卡的具体显存容量、功耗、接口和官方支持的框架版本,以英伟达官网和厂商页面为准,别听群里传的二手参数。
训练、微调、推理是三件事
训练吃的是显存带宽和卡间互联,单卡不够就得多卡,多卡之间通信慢,加卡也白搭。微调(比如 LoRA 那一套)对显存的要求低不少,消费卡也能试试。推理看的是延迟和并发,显存装得下权重加上 KV Cache 就基本能跑。麻烦在于很多人拿训练的预算去买卡,实际业务只跑推理,钱花冤枉了;反过来,拿消费卡硬上训练,跑几个小时崩一次,重跑的时间成本更要命。先给自己定位:是验证想法,还是要出东西。
显存这关,差一点点就是不能用
别只看参数表上那个数字。模型权重、优化器状态、激活值、KV Cache、batch size,一层层叠上去,占用量比你想的大。同一张卡,半精度和量化后的占用能差出一大截,量化的代价是精度和部分算子支持,这个得自己权衡。还有个常见坑,是拿别人一张截图当依据——单条短 prompt 跑通了,不代表你的业务并发上来还跑得动。选卡的时候留点余量,别卡着上限买,上线跑一周再回头看,多半会庆幸自己留了。
卡买对了,机器不一定装得下
数据中心卡是全长全高双槽、被动散热,家用机箱基本别想,得配服务器准系统、风道、大功率电源和专用供电接口,还得看主板 PCIe 插槽数量和通道怎么分配。装完还有机房那头:单机柜供电够不够、承重、散热、噪音。这些七七八八加起来,常常比卡本身的差价还高。买之前把这些列个清单,不然卡到了只能摆着看。
买还是租,这笔账按利用率算
利用率低就租,别犹豫。短期项目、验证阶段、预算紧、偶尔跑一次大任务,租云上的 GPU 最灵活,用完就停。利用率常年打满、数据敏感不愿意出机房、有稳定的长周期任务,再考虑自己买。租赁价格这几年波动不小,公开报价各家也不太一样,做预算的时候别拿老价格往上套,以服务商当期官方页面为准。云上的 GPU 型号和库存也经常调整,下单前确认清楚规格和计费方式。
二手卡便宜的那部分,通常是坑
二手市场水很深:挖过矿的、改过显存的、换过风扇的、序列号对不上的,都可能碰到。要买就当面测,跑压力测试看温度和降频,查显存有没有报错,核对序列号和保修状态,问清发票和保修能不能转。差那点钱,真出问题的时候修都修不了。
卡搞定之后,网站这边还有一半活
把 AI 能力接进网站,还有一堆事:接口要限流,不然被人刷爆;重任务得排队或者丢异步队列,别让一次生图把整站拖慢;结果能缓存就缓存,重复请求没必要再算一遍;带宽和 CDN 该上的上,静态资源别都回源。网站安全和成本控制也得同步,API key 别写在前端代码里,用量告警提前设好,不然账单和漏洞一起来。
落到行动上就四步:先写清楚业务是训练还是推理、并发大概多少;再按显存需求往上留一档余量;然后把机箱、电源、供电、散热、机位这些配套成本算进去;最后拿买和租的总成本对比一下,哪个划算走哪个。卡这东西,买贵了顶多心疼,买错了是真耽误事。
【版权声明】:本站所有内容均来自网络,若无意侵犯到您的权利,请及时与我们联系将尽快删除相关内容!