智算中心这行最容易搞错的地方,不在机房盖得漂不漂亮,而在上架之后到底是谁在用。邢台智算中心这类项目,外人看到的是机柜、GPU、PUE 三件套;真正决定它能不能活下去的,是三两个具体场景能不能长期把卡跑满。这两年追热点的见面就问“多少P”,我一般反问一句:这些算力给谁跑、合同签几年、网络和存储配了多少?答不上来的,多半还停在 PPT 阶段。
邢台智算中心的三个真实场景,往下拆
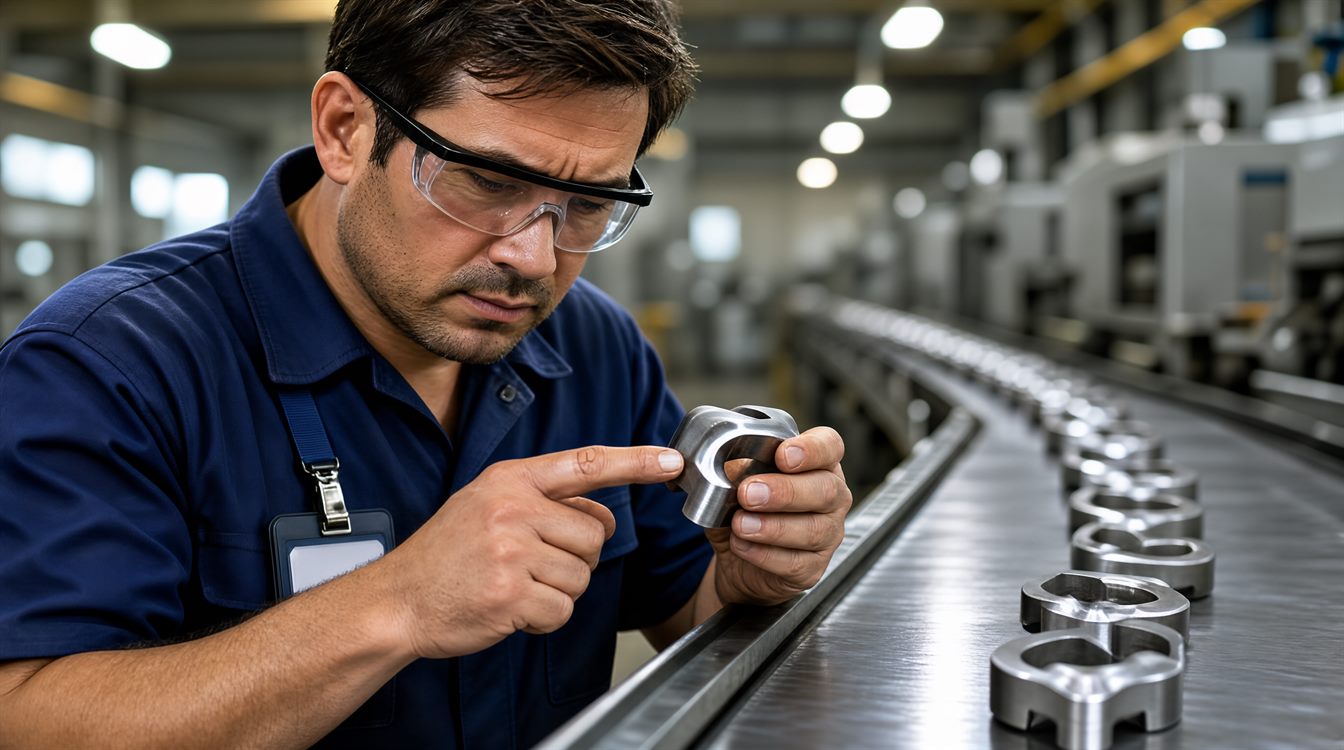
第一个是本地制造业的视觉质检和工艺优化。这类城市的产业底色,多半是装备制造、零部件、新材料、食品加工一类的活计,车间里最耗人的环节往往是靠眼睛看、靠老师傅经验判。视觉质检、缺陷识别、参数寻优这些模型规模不算大,但对数据不出厂、端到端时延有要求。产线上传一张图出去转一圈再回来,很多时候是来不及的。所以这类需求要的不是顶配卡,是就近、稳定、能长期陪着调;特点是“碎”,单子不大,黏性却高,一个产线跑顺了就会往上加工位。
第二个是城市治理和视频图像分析。城管、环保、交通的摄像头一天到晚在拍,全部原始视频往外地传,既不便宜也不合规,本地汇聚、本地推理是更自然的做法。这类业务真正吃的是并发路数和长时间的稳定推理,不是训练。你给它配一堆顶配训练卡,反而是浪费;把推理卡、视频解码、对象存储和出网带宽配匀了,才跑得舒服。它买的是“就近”,不是“最强”。
第三个是本地高校、职院、医院和科研机构的小规模微调与推理。他们手里的数据量通常不大,一次微调可能就几张卡跑几天,更多时候是在做推理验证和小实验。大厂看不上这种小单,可恰恰是这类小单撑起了区域智算中心的日常上架率。你要是只按大客户训练集群的思路去设计计费和调度,这批人第一个跑掉。
一看就不对劲的几类需求
有冲着牌子和补贴来的:机房建起来了,机柜空着,等政策周期一过就断粮;有把智算中心当普通 IDC 卖的,客户要的是机柜位和带宽,卡一张没动;还有只盯着训练、觉得推理不挣钱的——天天在跑的偏偏是推理。判断办法很土:连续三个月晚上八点卡的利用率是多少,敢不敢把监控截图拿出来给客户看。拿不出来,宣传口径再漂亮也白搭。
训练和推理是两门生意,别混着算
训练要的是卡间互联和并行效率,数据交换量大,网络一抖,全体等在那儿;推理要的是单卡性价比、批处理能力、显存够不够装下上下文,还有弹性伸缩。很多人买卡按训练口径算账,最后跑的全是推理业务,钱就花冤了。反过来也一样,拿推理卡去凑训练集群,跑一个 epoch 等到怀疑人生。选型之前先问自己:我的负载里训练占几成、推理占几成、峰值在什么时段。这个问题不清楚,谈什么算力规模都是空的。
网络和存储跟不上,卡再多也是摆设
智算项目里最容易被砍预算的,就是网络和存储。参数面走 RoCE 还是 IB,交换机、光模块、网卡都得配齐,这部分钱不比卡少多少;存储侧要并行文件系统,小文件一多最考验人。我见过把训练数据直接扔在普通 NAS 上的,读一轮数据的时间比训练还长。还有个细节常被忽略:数据从采集端到机房这一段,是靠专线还是靠公网,走的路径不同,后面的运维成本完全两码事。
电和散热,是要按十年算的账
电价、PUE、市电容量、变压器、UPS,一项一项都是钱。液冷还是风冷,取决于单机柜功率密度,不是看谁时髦。走风冷就得留足冷通道和冗余,上液冷就得想清楚运维队伍养不养得起、备件从哪来、漏液了怎么办。这类投入回收期往往按年算,决策就得按十年算;只看第一年的建设报价,后面年年都要为省下的那点钱买单。
小团队到底要不要碰
建站的、做 SaaS 的、跑小模型的团队,自建基本是给自己找事。租算力更现实:按卡、按小时、按天计费都行,先把业务跑通,再谈长期包用。要留退路——模型权重和数据要能整体搬走,镜像和依赖要能重建,训练脚本别绑死在某一家的专有环境里。这一点对准备上云的人,比选哪家、便宜多少都重要;具体资费和规格以服务商或官方页面说明为准,别信口头承诺。
落到实处的判断清单
看一个智算中心靠不靠谱,我会问四件事。第一,现有客户名单里,本地场景占几成,合同周期多长;第二,网络是自建还是租用,出口带宽够不够同时喂训练和推理;第三,运维团队是自己的人还是外包,出事多久能到现场;第四,能不能提供按需弹性,让客户在业务低谷期把卡释放出来。四条里有两条含糊,后面大概率要靠补贴续命。
绕一圈回到那句话:智算中心不是算力批发市场,是替具体场景配的基础设施。谁在用、用来干什么、能持续多久,这三个问题答清楚,机柜和卡才有意义。参数和投资额去看官方公告和公开报道,别让宣传册替你做决定。
【版权声明】:本站内容若无意侵犯到您的权利,请及时与我们联系将尽快删除相关内容!