内存带宽吃紧加内存条救不卡顿,这话听着像绕口令,但确实是我见过太多人踩过的坑:钱花了,条插了,开机一看该卡还是卡。容量和带宽压根是两码事,容量像仓库面积,带宽像仓库门口那条路。你仓库扩了一倍,门口还是单车道,货车该堵照样堵。更冤的是,有些人加完条连双通道都没组上,等于路没修,只多租了一间库房。
内存带宽吃紧加内存条救不卡顿,先看通道插对没
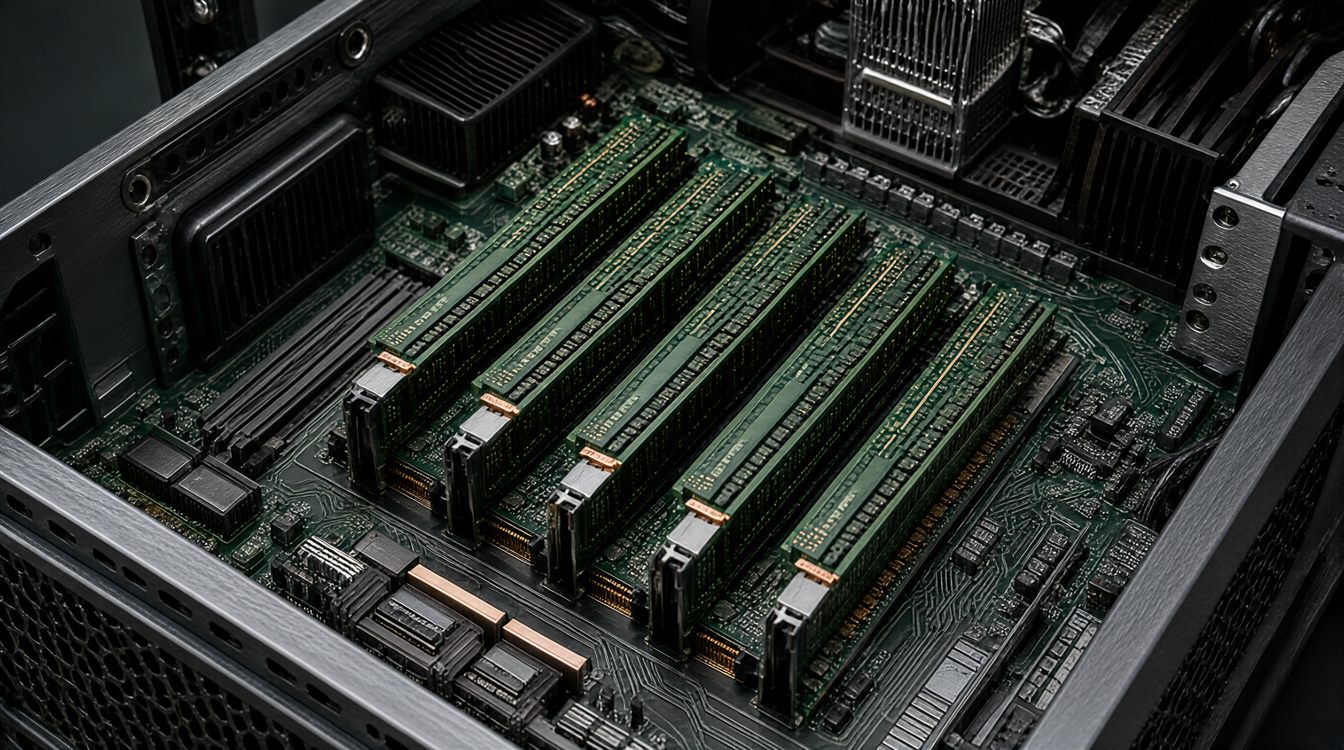
内存带宽说白了就是内存和CPU之间搬数据的速率。算法不复杂:频率乘位宽除八,再乘通道数。拿DDR4-3200举例,单通道理论带宽25.6GB/s,双通道翻倍到51.2GB/s。你原来一根8G,再加一根8G,如果插在主板指定的双通道槽位上,带宽才翻倍;插错了,两条各自跑单通道,容量是大了,带宽没动。很多人拆开机箱随手插在离CPU最近的两个槽,看着挺顺,主板说明书上写的却是A2和B2。服务器更明显,CPU支持几通道,内存就得按通道数插满,少一条都吃不满。具体插法别猜,看主板手册或者服务商给的说明。
频率混插,加条反而可能降速
还有个常见操作:原来一根3200,后来翻出一根2666,想着凑合用。结果系统按低的跑,全降到2666,带宽不升反降。DDR4和DDR5更别混,物理防呆都不一样。服务器上的ECC、REG也分场景,乱插可能点不亮。云主机用户摸不到插槽,但道理一样:实例规格往往绑定了内存带宽和CPU配额,共享型、突发型不是想加就加。到底给多少,以服务商官方页面说明为准,别拿物理机的经验硬套。
容量管装得下,带宽管搬得快
容量不够的表现很直接:Swap频繁读写、OOM killer出手、数据库缓存命中率低、跑个大点的应用就报内存不足。带宽不够的表现更隐蔽:CPU几个核跑不满,压测吞吐上不去,延迟一阵一阵抖,看监控内存占用也不算高。普通网站卡顿,很多时候根本不是内存容量的事,磁盘IO、慢查询、PHP-FPM进程数、连接数打满、网络丢包,哪个都能让页面转圈。Linux还有个习惯,空闲内存拿去做缓存,free看着快满了,available其实还有余量。只看used就加条,容易花冤枉钱。
卡顿这口锅,内存不一定背
我碰到过一台机器,页面一到大白天就卡,内存占用看着也高,先加了内存,没缓解。后来上iostat一看,磁盘%util长时间顶满,慢在IO。还有一次是定时任务跟业务抢CPU,内存条换了也没用。云主机上还要看steal,宿主机资源紧张的时候,你的CPU时间被借走,表现也是卡。数据库慢查询、连接池不够、代码里死循环,这些更常见。加内存顶多让缓存多装点,SQL该慢还是慢。
三条命令,先把底摸清
别急着下单,先登机器看几眼。free -h看available和swap,swap持续有进出就不是好信号;vmstat 1看si、so、wa和r队列,r长期大于核数说明CPU排队,wa高多半卡在IO;iostat -x 1看%util和await,磁盘饱和一眼能看出来。想确认通道和频率,用dmidecode -t memory,需要root,云主机可能读不到物理信息;lscpu能看NUMA和CPU拓扑。命令只是工具,别背,按系统来。看不懂就截图问服务商,比瞎加条强。
什么情况下加内存条真有用
也不是说加内存一无是处。available长期很低、swap一直在读写、OOM日志隔三差五出现、缓存命中率上不去、并发连接一多每个进程都吃内存,这种加容量是对症的。加完别只看“内存变大了”,回来看swap有没有降、缓存命中率有没有升、OOM还出不出现。要是这些都没变,说明瓶颈不在容量。带宽不够的话,该考虑的是更高频率、把通道插满、换平台,或者把压力拆到多台机器上。升级顺序别搞反:先监控定位,再优化应用和索引,再动通道频率,最后才加容量。
云主机上,内存条不是想加就加
云主机没有“拔下来换一根”这回事,内存和带宽都锁在实例规格里。你能做的是看监控、升规格、把服务拆开。看到内存使用率高就升配,容易升完还是卡。先看available、swap、steal,再看磁盘和网络。不同服务商的监控口径不一样,有的把缓存算进使用率,有的单列。拿不准就以官方文档和工单回复为准,别信群里随手截的图。
下次再遇到卡顿,先别打开购物车。看一眼内存通道插对没、频率有没有被拉低、available还剩多少、磁盘IO饱不饱。这几样排完,再决定是加条、换平台,还是回去改代码。内存条是好东西,但它治不了所有卡顿。
【版权声明】:本站内容若无意侵犯到您的权利,请及时与我们联系将尽快删除相关内容!