大数据起源探究,大模型微调对数据有何具体要求?

大数据起源于20世纪90年代,随着互联网和信息技术的发展而兴起。大模型微调通常需要大量、多样化且高质量的数据来确保模型的准确性和泛化能力。

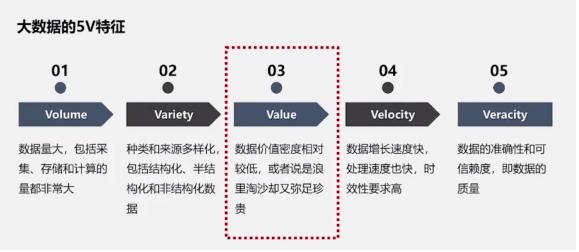
大数据的起源可以追溯到20世纪90年代,当时由于互联网的迅猛发展和数字化信息的爆炸式增长,传统的数据处理技术已经无法有效地处理如此大规模的数据,大模型微调对数据的要求包括数据的相关性、数据的质量、数据的多样性等方面;大数据的起源包括互联网和计算的发展、关键技术进步、产业和应用的发展等方面。
大数据的起源_大模型微调需要的数据有要求吗?
(图片来源网络,侵删)

大数据的起源:

1、互联网和计算的发展:

在20世纪90年代,随着互联网的普及和个人电脑的广泛使用,数字数据量开始激增,根据研究,大数据的概念首次出现在这个阶段,描述的是那些无法通过传统数据库和处理工具有效管理和分析的大规模数据集。

互联网不仅使数据量大增,也改变了数据的产生和流通方式,社交媒体、在线交易和数字通信等都为大数据的增长做出了贡献。

2、关键技术进步:

进入21世纪,云计算的出现为存储和处理大数据提供了新的可能,云服务提供了弹性的计算资源和存储空间,使得企业和研究机构能够更加经济有效地处理大数据问题。

分布式系统的发展,尤其是Hadoop的推出,为处理大规模数据集提供了新的方法,Hadoop能够高效地处理和分析PB级别以上的数据集,极大地推动了大数据技术的应用和发展。

3、产业和应用的发展:
大数据的起源_大模型微调需要的数据有要求吗?
(图片来源网络,侵删)

从2000年代开始,互联网公司如谷歌和亚马逊开始利用大数据优化其服务,谷歌使用大数据来改进其搜索引擎的算法,而亚马逊则用它来优化用户体验和增加销售效率。

随着物联网(IoT)技术的发展,从传感器收集的数据量也显著增加,进一步丰富了大数据的来源和应用范围。

大模型微调的数据要求:

1、数据的相关性:

微调大模型时,数据需要与特定领域或任务紧密相关,如果模型将被用于金融分析,那么微调数据应具有金融市场的相关数据,如股票价格、市场新闻等。

这种相关性确保模型能够学习到领域内的关键信息,提高其在该领域的表现。

2、数据的质量:

数据质量直接影响模型的性能,高质量的数据应该是准确的、一致的并且是最新的。
大数据的起源_大模型微调需要的数据有要求吗?
(图片来源网络,侵删)

错误或过时的数据可能会导致模型学习错误的模式,影响其预测和分析的准确性。

3、数据的多样性:

为了使模型具有更好的泛化能力,微调数据集应该包含多种场景和案例,这可以帮助模型在遇到新的情况时做出更准确的反应。

在训练一个语音识别模型时,数据集应包括不同口音、语速和背景噪音下的语音样本。

4、数据的格式和规模:

输入模型的数据需要符合特定的格式,如JSON, CSV等,同时数据的规模要适中,既不能太小以至于不能全面代表领域特征,也不能太大导致处理效率低下。

微调数据集的大小从几千到几万个样本不等,具体取决于模型的复杂性和应用领域的需求。

大数据的概念最早源于面对海量数据的处理需求,而大模型微调则需要精心挑选符合特定标准的数据来保证模型的最优性能,理解这些起源和要求有助于更好地应用这些技术解决实际问题。

【版权声明】:本站所有内容均来自网络,若无意侵犯到您的权利,请及时与我们联系将尽快删除相关内容!

赞 (0)
爱国的头像爱国
如何成功构建一个实时报警的CDN同步平台?
上一篇 2024-08-06 10:30
佛山网站建设公司如何提供有效的网站管理服务?
下一篇 2024-08-06 10:36

相关推荐

  • 负载均衡器如何影响系统性能?

    负载均衡器在现代网络架构中扮演着至关重要的角色,其主要功能是通过将流量分配到多个服务器上,以提高系统的响应速度、处理能力和可靠性,负载均衡器的性能对整体系统性能的影响是一个复杂的话题,涉及多个方面,以下是对负载均衡器对性能影响的详细分析:一、负载均衡算法的影响负载均衡算法是决定如何将请求分配给后端服务器的核心因……

    2024-12-19
    0025
  • 什么网站可以买到靠谱的虚拟主机账号?

    在数字化时代,拥有一个网站是个人、企业或组织展示形象、拓展业务的关键一步,而虚拟主机作为网站运行的基础设施,其选择至关重要,许多初学者在搭建网站时,首先会问:“什么网站有虚拟主机卖号?” 这个问题实际上是在探寻可靠的虚拟主机购买渠道,市场上的服务商琳琅满目,各有侧重,了解它们的特点是做出明智选择的前提,国际知名……

    2025-10-14
    0017
  • 剑网3玩家如何选择最佳服务器?

    选择剑网3服务器时,应考虑服务器稳定性、玩家人数、PvP和PvE环境及社交氛围。建议加入活跃的公会,参考游戏社区评价,并关注官方公告以获得最新信息。适合自己游戏风格和偏好的服务器是最佳选择。

    2024-09-05
    0066
  • 大数据常用的命令是_常用命令

    大数据领域常用的命令主要包括Hadoop、Spark等框架的操作命令,以及SQL查询语句。以下是一些常用命令的简要介绍:,, 1. Hadoop文件系统(HDFS)命令:, * hadoop fs mkdir: 创建目录, * hadoop fs put: 上传文件到HDFS, * hadoop fs get: 从HDFS下载文件, * hadoop fs ls: 列出目录内容, * hadoop fs du: 显示目录大小, 2. YARN(Yet Another Resource Negotiator)命令:, * yarn application list: 列出所有运行中的YARN应用, * yarn application kill: 杀死一个YARN应用, 3. Apache Spark命令:, * sparksubmit: 提交Spark作业, * sparkshell: 启动Spark shell, 4. Hive和Pig命令:, * hive: 进入Hive交互模式, * pig: 进入Pig交互模式, 5. SQL查询语句:, * SELECT: 从数据库表中选取数据, * INSERT INTO: 向数据库表中插入数据, * UPDATE: 更新数据库表中的数据, * DELETE: 从数据库表中删除数据, * CREATE TABLE: 创建新表, * DROP TABLE: 删除表, * ALTER TABLE: 修改表结构,,这些仅仅是大数据领域中常用命令的冰山一角。大数据生态系统中包含了众多的工具和技术

    2024-07-15
    0012

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

广告合作

QQ:14239236

在线咨询: QQ交谈

邮件:asy@cxas.com

工作时间:周一至周五,9:30-18:30,节假日休息

关注微信